


Término: Datos Estructurados
DSH IRI: https://descriptor.es/concept/structured-data/
Término de Glosario por: Ricard Menor
Actualizado 22/09/2026
Datos Estructurados
Término: Datos Estructurados
DSH IRI: https://descriptor.es/concept/structured-data/
Término de Glosario por: Ricard Menor
Actualizado 22/09/2026
Datos Estructurados
Término: Datos Estructurados
DSH IRI: https://descriptor.es/concept/structured-data/
Término de Glosario por: Ricard Menor
Actualizado 22/09/2026
Datos Estructurados
Término: Datos Estructurados
DSH IRI: https://descriptor.es/concept/structured-data/
Término de Glosario por: Ricard Menor
Actualizado 22/09/2026
Datos Estructurados: Se refiere a la información que está organizada en un formato o patrón específico, lo que facilita su búsqueda, análisis y comprensión.
Piensa en ello como un archivador bien organizado donde cada archivo tiene una etiqueta clara y está colocado en un cajón específico, de una forma específica.
Además disponen de una utilidad añadida: no solamente contienen información útil para algún cometido, también describen las relaciones entre las distintas fuentes de datos.
Un documento con datos estructurados tiene el potencial de no solamente darte la información que contenga, también te indicará su número de orden en una secuencia lógica de documentos, por ejemplo. Eso daría mayor valor y utilidad a los datos consumidos.
Ejemplos de Datos Estructurados:
- Imágenes: las imágenes marcadas como Código de Barras EAN13.
Este tipo de imagen se identifica de tres formas, una por la distribución de las barras en la imagen visible (código numérico, típicamente EAN13 que también es un estándar de Datos Estructurados), el tipo de imagen (puede ser identificado usando un vocabulario controlado como Schema.org); otra por sus metadatos acompañantes. - Documentos de texto digitales:

Datos No Estructurados
Por contra, los Datos No Estructurados se refieren a la información que no sigue un formato o patrón específico y, por lo tanto, es más difícil de organizar, buscar y analizar.
Piensa en ello como una caja llena de papeles sueltos sin ningún orden particular.
Cada papel suelto y desordenado contiene información, pero cuesta mucho relacionarlo con otros papeles y documentación desparramada sin orden aparente.
Ejemplos de Datos No Estructurados:
- Textos Libres: Documentos de texto, correos electrónicos, publicaciones en redes sociales.
- Imágenes y Videos: Fotografías, videos, gráficos.
- Archivos de Audio: Grabaciones de voz, podcasts, música.
- Documentos Escritos a Mano: Notas, cartas, manuscritos, albaranes, facturas.
Diferencias Clave
- Organización:
- Estructurados: Siguen un formato específico y están organizados de manera sistemática.
- No Estructurados: No siguen un formato específico y están organizados de manera más libre y heterogénea.
- Facilidad de Análisis:
- Estructurados: Son más fáciles de analizar y procesar debido a su organización.
- No Estructurados: Son más difíciles de analizar y procesar debido a la falta de estructura y a la posible existencia de muchas excepciones.
- Ejemplos de Uso:
- Estructurados: Bases de datos, hojas de cálculo, formatos como JSON y XML. Usos: Ciencia, EDI, SEO.
- No Estructurados: Documentos de texto, imágenes, videos, archivos de audio. Usos: cultura, ocio, comunicación.
Datos Estructurados en el mundo real
Los datos estructurados son ideales para aplicaciones que requieren un alto grado de organización y facilidad de análisis, como bases de datos y aplicaciones web. No olvidemos que un sitio web es un tipo de aplicación web, de ahí la importancia de incluir Schema SEO en los esfuerzos de posicionamiento web.
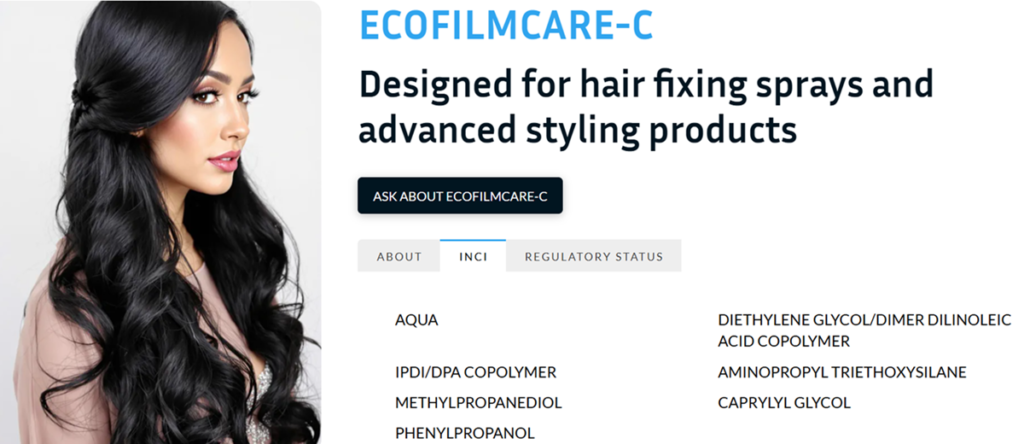
Productos cosméticos / Sector Industrial
Hostelería, HORECA, Bodegas y Sectores Primarios
¡Algo tan personal e intransferible como la cata de vinos! Debe ser ordenado y estandarizado para poder formar sommeliers y clasificar las notas de cata de los distintos caldos de cara al consumidor.
Así podemos pasar de «este vino está bien» a «me gusta el vino con notas cítricas y frutos rojos».
Casi sin querer, hemos llegado a un caso clarísimo de acercamiento del producto a su público objetivo. Y es que al dotar al público de esta estructura de datos, este conocimiento, le permitimos expresar su necesidad de forma objetiva: se autosegmenta.
Si pones el cartel «Notas cítricas y frutos rojos» en el lineal de vino tinto, sabrás enseguida quién sabe lo que busca.
Lectura y Cine
Por otro lado, los datos no estructurados son más comunes en contextos donde la información es más libre y variada, en contextos de ocio por ejemplo: documentos de texto literario y medios audiovisuales. Leer e ir al cine o al teatro.
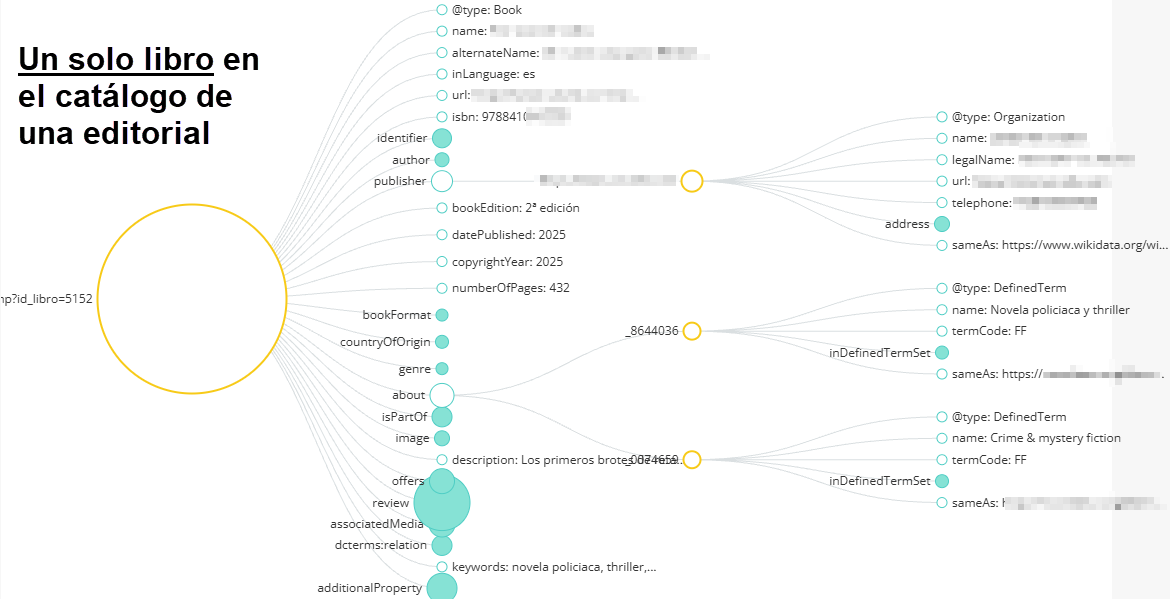
¿Sabías que…? Para ti es una lectura agradable sin más estructura que tus horarios. Pero para el librero o la editorial, hay una gran cantidad de datos estructurados disponibles para catalogar y gestionar cualquier fondo editorial.
Vivimos una realidad híbrida
Ya no estamos solos, ahora somos humanos e IAs. Como sofontes, ambos tipos de datos tienen sus propios usos y desafíos, y a menudo se utilizan en conjunto para obtener una visión más completa de la información.
Pongamos el ejemplo de una obra de arte, un cuadro. Vamos a examinar como podría percibirse siendo un observador casual (una persona que admira la pintura y el arte) o bien un ordenador que reconozca el cuadro (no lo reconocerá literalmente, sino que diferenciará la imagen que capte de este o bien identificará una serie de datos únicos de esta obra de arte).
El cuadro artístico como Datos No Estructurados:
- Una Persona lo verá en su conjunto, puede fijarse en aspectos concretos de zonas concretas del lienzo, puede ver sus colores, puede incluso sentir emociones basadas en esta experiencia.
Pero la gama de colores será falsa, porque será lo que perciben sus ojos: estos colores dependerán de la luz disponible, la salud ocular del observador, el estado de ánimo, etc.
Pero un observador casual puede no saber quién es el artista, ni en qué momento de su vida creó el cuadro, ni qué orden tiene la obra en su colección, ni cuantos colores distintos tiene, etc. - Un ordenador equipado con una cámara puede ser preparado para escanear el cuadro, puede percibir millones de colores, puede comparar la obra con otras y ejecutar decenas de operaciones, pero se centrará en la imagen del objeto. Será solamente un objeto desconocido frente al objetivo de la cámara.
El cuadro artístico como Datos Estructurados:
- Una Persona que se dedique a catalogar y organizar colecciones de arte puede tratar el cuadro concreto como un elemento perfectamente identificado y ubicado entre otros elementos similares, sea por autor, por época, por técnica, etc. Puede gestionar este cuadro para preservarlo y que otras personas puedan disfrutarlo.
- Un ordenador puede alojar una base de datos sobre colecciones de arte, perfectamente catalogadas y organizadas mediante información añadida al cuadro identificado. No añadida directamente sobre el cuadro, sino sobre su representación digital en forma de identificador URI.
Esta información almacenada en un ordenador puede contener una definición de un vocabulario controlado, una «etiqueta» que indica de forma unívoca (un solo significado, sin ambigüedades) de qué tipo de cosa -objeto tangible o intangible- se trata. En breve sigo con esta «etiqueta»*.
La creación, mantenimiento y explotación de esta información permite a la Persona que gestiona el cuadro hacer su trabajo y con ello crear conocimiento universal.
SOLID SEO

Consultoría e Implementación
Más de 20 años de experiencia y conocimiento SEO de todas las épocas y tecnologías se unen a una metodología robusta y sostenible
CONTACTA SIN COMPROMISO
Vocabularios controlados
Se les llama controlados porque son mantenidos de forma coordinada por varias partes, entre instituciones, investigadores, empresas, etc. De esta forma, se publican regularmente los cambios y mejoras que reciben. Un profesional SEO hábil con Schema debe estar al día de dicho vocabulario, por mencionar un caso de amplia penetración en el mercado del marketing online.
¿He mencionado ya que Schema es el vocabulario recomendado por Google?
- Schema: En el contexto de la web, Schema.org es un vocabulario que ayuda a estructurar datos para que los motores de búsqueda puedan entenderlos mejor. Por ejemplo, un restaurante podría usar Schema para listar su menú, horarios de operación y ubicación de una manera que Google pueda mostrar fácilmente en los resultados de búsqueda.
*Ejemplo: retomando la «etiqueta» del cuadro del ejemplo anterior, el vocabulario Schema.org permite «etiquetar» un cuadro artístico como un elemento o entidad del tipo Painting. - IPTC (International Press Telecommunications Council): Es un vocabulario utilizado principalmente en el ámbito de los medios de comunicación y la fotografía. Proporciona un conjunto de metadatos estándar para describir imágenes y otros contenidos multimedia, facilitando su organización y búsqueda. Es usado masivamente en cadenas de televisión, prensa o bancos de imágenes.
- Dublin Core: Es un vocabulario simple y ampliamente utilizado para describir recursos digitales. Incluye un conjunto de 15 elementos básicos, como título, autor, fecha y formato, que ayudan a catalogar y buscar información de manera eficiente. Es comúnmente utilizado en bibliotecas y repositorios digitales; uno de los decanos, que vengo usando desde finales del siglo XX.
- FOAF (Friend of a Friend): Otro anciano. Es un vocabulario utilizado para describir personas y sus relaciones. Permite crear perfiles de usuarios y establecer conexiones entre ellos, lo que fue útil en redes sociales y aplicaciones de gestión de contactos. FOAF es uno de los primeros ejemplos de uso relativamente masivo de RDF para estructurar la información, y se añadió a Schema en 2011, aunque sigue usándose independientemente.
[ Volver al origen ]
Formatos para expresar conceptos usando vocabularios controlados
- RDF (Resource Description Framework): Es un lenguaje para describir información en un formato estructurado. Imagina un catálogo de biblioteca donde cada libro tiene un título, autor y fecha de publicación. RDF puede ser utilizado para describir estas relaciones de una manera que las computadoras puedan entender. Aquí tienes mi artículo de introducción al RDF.
- JSON-LD (JavaScript Object Notation + Linked Data): Es un formato ligero para almacenar y transportar datos, ligado a Datos Enlazados. Piensa en ello como un libro de recetas donde cada receta tiene una lista de ingredientes y pasos. JSON es a menudo utilizado en aplicaciones web para enviar datos entre un servidor y una página web.
Es el formato recomendado por Google para el marcado de Datos Estructurados en un sitio web. - XML (eXtensible Markup Language): Es otro formato para estructurar datos. Es como un conjunto de instrucciones para ensamblar un mueble, donde cada parte está claramente etiquetada y los pasos están numerados. XML es utilizado en muchas industrias, como en finanzas para registros de transacciones o en publicaciones para el formato de documentos.
Su grandeza y amplio uso radican en el hecho de que como su nombre indica, es un formato extensible.
Si trabajas con EDI (logística, finanzas, administración, compras, transportes, gran consumo, etc), estás tocando XML cada día.
Introducción a RDF y la Web Semántica
RDF y la Web Semántica: RDF es fundamental para la Web Semántica, que es una extensión de la web actual donde la información está estructurada y enlazada de manera que las computadoras puedan entenderla y procesarla. La Web Semántica busca hacer que la información en la web sea más significativa y útil, permitiendo que las máquinas comprendan el contexto y las relaciones entre diferentes datos.
Este formato permite utilizar a la vez varias ontologías o vocabularios controlados, de forma que quien quiera usarlo disponga de elementos y atributos específicos a su campo de trabajo.
Por ejemplo, en el caso del cuadro que comentaba antes: en una base de datos o en una página web de un museo tenemos Datos Estructurados expresados en formato JSON-LD y vocabulario Schema.org (metadatos sobre la obra), a la vez una captura digital de la obra podría ser referida en estos Datos Estructurados usando el vocabulario específico de IPTC (metadatos de la imagen digital de la obra), mientras que se podría usar términos de la iniciativa Dublin Core para describir la relación entre varios ficheros digitales que ayudan a identificar, gestionar y preservar el valioso cuadro.
Triples
En el contexto de los datos estructurados, un triple es una forma de describir una pieza de información en tres partes: sujeto, predicado y objeto. Por ejemplo, en la afirmación «El libro 1984 fue escrito por George Orwell,» el sujeto es «El libro 1984,» el predicado es «fue escrito por,» y el objeto es «George Orwell.» Este formato es a menudo utilizado en RDF para describir relaciones entre diferentes piezas de datos, este es pues su unidad mínima de trabajo, un solo triple:
Libro > escrito por > Autor que se lee como
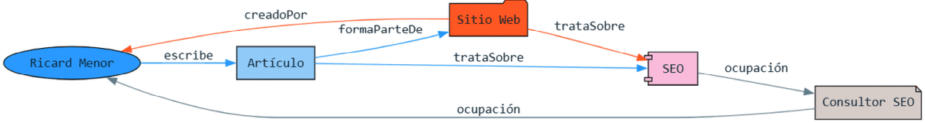
Sujeto > predicado > ObjetoPasamos ahora de un solo triple a un ejemplo con 7 triples. Aquí se puede ver como se teje el conocimiento a partir de premisas sencillas (triples aislados que crean un contexto superior al relacionarse):
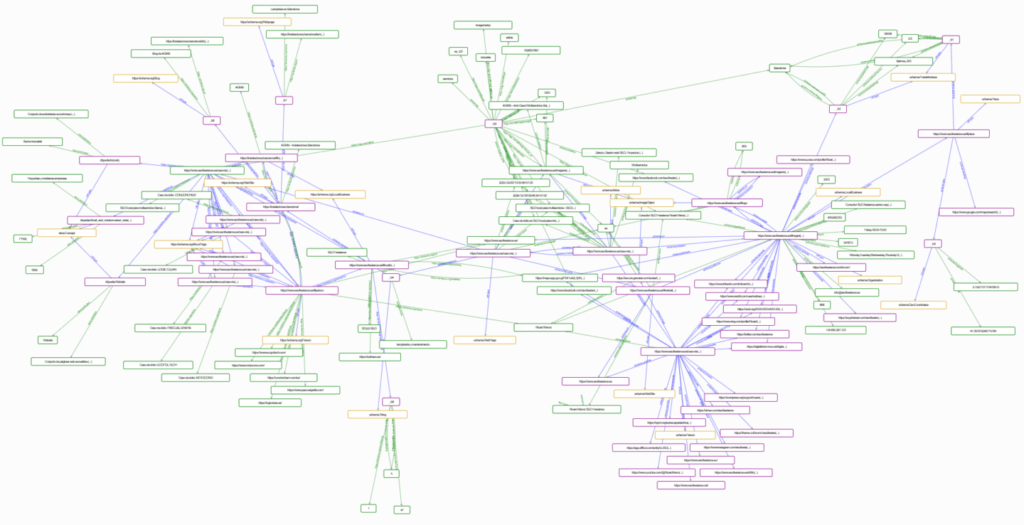
Si seguimos elevando la complejidad de las relaciones entre un mayor número de triples, acabamos con visualizaciones densas como este ejemplo real de mi portafolio de clientes:
Nota del autor: resulta interesante matizar el ejemplo básico, como refuerzo de la disparidad entre lenguaje humano y lenguaje estructurado para consumidores de datos:
El predicado «fue escrito por» es natural entre humanos, pero no sería correcto ni preciso en la Web Semántica.
En un entorno interoperable, el predicado es siempre una propiedad formal (URI), para el caso del ejemplo sería schema:author usando el vocabulario Schema.org, si usamos otro como Dublin Core podría ser dcterms:creator.
Entidad Libro [schema:Book] > Propiedad [schema:author] > Entidad Persona [schema:Person]Al utilizar datos estructurados, la sociedad digital puede hacer que su información sea más accesible, indexable y reutilizable; por tanto la información no solamente existe sino que es útil tanto para las personas como para las computadoras. Esta infraestructura de conocimiento es obviamente una herramienta extremadamente valiosa para las industrias, de muchas formas distintas; una de las más evidentes es el Posicionamiento SEO. Organizando y estructurando el contenido se pueden obtener 2 cosas:
- Visibilidad online, mejor interacción con LLMs (IA): si entienden tu empresa, será más visible/citable.
- Conocimiento, ya que cualquier LLM comercial con contexto adecuado puede inferir información nueva a partir de informaciones ya conocidas, pero no relacionadas o vistas «con poco ángulo».
Conceptos relacionados (y otro triple de ejemplo)
[ SOLID SEO ] > [ Consultoría ] > [ SEO ] = [ Empresa ] > [ actividad ] > [ Producto/Servicio ]
Fuentes y relaciones
- Schema SEO: Datos Estructurados [ https://www.seofreelance.es/schema-seo/ ]
- Descriptor Semántico Homogéneo® [ https://www.seofreelance.es/descriptor-semantico-homogeneo-dsh/ ]
Datos Estructurados: Se refiere a la información que está organizada en un formato o patrón específico, lo que facilita su búsqueda, análisis y comprensión.
Piensa en ello como un archivador bien organizado donde cada archivo tiene una etiqueta clara y está colocado en un cajón específico, de una forma específica.
Además disponen de una utilidad añadida: no solamente contienen información útil para algún cometido, también describen las relaciones entre las distintas fuentes de datos.
Un documento con datos estructurados tiene el potencial de no solamente darte la información que contenga, también te indicará su número de orden en una secuencia lógica de documentos, por ejemplo. Eso daría mayor valor y utilidad a los datos consumidos.
Ejemplos de Datos Estructurados:
- Imágenes: las imágenes marcadas como Código de Barras EAN13.
Este tipo de imagen se identifica de tres formas, una por la distribución de las barras en la imagen visible (código numérico, típicamente EAN13 que también es un estándar de Datos Estructurados), el tipo de imagen (puede ser identificado usando un vocabulario controlado como Schema.org); otra por sus metadatos acompañantes. - Documentos de texto digitales:
Datos No Estructurados
Por contra, los Datos No Estructurados se refieren a la información que no sigue un formato o patrón específico y, por lo tanto, es más difícil de organizar, buscar y analizar.
Piensa en ello como una caja llena de papeles sueltos sin ningún orden particular.
Cada papel suelto y desordenado contiene información, pero cuesta mucho relacionarlo con otros papeles y documentación desparramada sin orden aparente.
Ejemplos de Datos No Estructurados:
- Textos Libres: Documentos de texto, correos electrónicos, publicaciones en redes sociales.
- Imágenes y Videos: Fotografías, videos, gráficos.
- Archivos de Audio: Grabaciones de voz, podcasts, música.
- Documentos Escritos a Mano: Notas, cartas, manuscritos, albaranes, facturas.
Diferencias Clave
- Organización:
- Estructurados: Siguen un formato específico y están organizados de manera sistemática.
- No Estructurados: No siguen un formato específico y están organizados de manera más libre y heterogénea.
- Facilidad de Análisis:
- Estructurados: Son más fáciles de analizar y procesar debido a su organización.
- No Estructurados: Son más difíciles de analizar y procesar debido a la falta de estructura y a la posible existencia de muchas excepciones.
- Ejemplos de Uso:
- Estructurados: Bases de datos, hojas de cálculo, formatos como JSON y XML. Usos: Ciencia, EDI, SEO.
- No Estructurados: Documentos de texto, imágenes, videos, archivos de audio. Usos: cultura, ocio, comunicación.
Datos Estructurados en el mundo real
Los datos estructurados son ideales para aplicaciones que requieren un alto grado de organización y facilidad de análisis, como bases de datos y aplicaciones web. No olvidemos que un sitio web es un tipo de aplicación web, de ahí la importancia de incluir Schema SEO en los esfuerzos de posicionamiento web.
Productos cosméticos / Sector Industrial
Hostelería, HORECA, Bodegas y Sectores Primarios
¡Algo tan personal e intransferible como la cata de vinos! Debe ser ordenado y estandarizado para poder formar sommeliers y clasificar las notas de cata de los distintos caldos de cara al consumidor.
Así podemos pasar de «este vino está bien» a «me gusta el vino con notas cítricas y frutos rojos».
Casi sin querer, hemos llegado a un caso clarísimo de acercamiento del producto a su público objetivo. Y es que al dotar al público de esta estructura de datos, este conocimiento, le permitimos expresar su necesidad de forma objetiva: se autosegmenta.
Si pones el cartel «Notas cítricas y frutos rojos» en el lineal de vino tinto, sabrás enseguida quién sabe lo que busca.
Lectura y Cine
Por otro lado, los datos no estructurados son más comunes en contextos donde la información es más libre y variada, en contextos de ocio por ejemplo: documentos de texto literario y medios audiovisuales. Leer e ir al cine o al teatro.
¿Sabías que…? Para ti es una lectura agradable sin más estructura que tus horarios. Pero para el librero o la editorial, hay una gran cantidad de datos estructurados disponibles para catalogar y gestionar cualquier fondo editorial.
Vivimos una realidad híbrida
Ya no estamos solos, ahora somos humanos e IAs. Como sofontes, ambos tipos de datos tienen sus propios usos y desafíos, y a menudo se utilizan en conjunto para obtener una visión más completa de la información.
Pongamos el ejemplo de una obra de arte, un cuadro. Vamos a examinar como podría percibirse siendo un observador casual (una persona que admira la pintura y el arte) o bien un ordenador que reconozca el cuadro (no lo reconocerá literalmente, sino que diferenciará la imagen que capte de este o bien identificará una serie de datos únicos de esta obra de arte).
El cuadro artístico como Datos No Estructurados:
- Una Persona lo verá en su conjunto, puede fijarse en aspectos concretos de zonas concretas del lienzo, puede ver sus colores, puede incluso sentir emociones basadas en esta experiencia.
Pero la gama de colores será falsa, porque será lo que perciben sus ojos: estos colores dependerán de la luz disponible, la salud ocular del observador, el estado de ánimo, etc.
Pero un observador casual puede no saber quién es el artista, ni en qué momento de su vida creó el cuadro, ni qué orden tiene la obra en su colección, ni cuantos colores distintos tiene, etc. - Un ordenador equipado con una cámara puede ser preparado para escanear el cuadro, puede percibir millones de colores, puede comparar la obra con otras y ejecutar decenas de operaciones, pero se centrará en la imagen del objeto. Será solamente un objeto desconocido frente al objetivo de la cámara.
El cuadro artístico como Datos Estructurados:
- Una Persona que se dedique a catalogar y organizar colecciones de arte puede tratar el cuadro concreto como un elemento perfectamente identificado y ubicado entre otros elementos similares, sea por autor, por época, por técnica, etc. Puede gestionar este cuadro para preservarlo y que otras personas puedan disfrutarlo.
- Un ordenador puede alojar una base de datos sobre colecciones de arte, perfectamente catalogadas y organizadas mediante información añadida al cuadro identificado. No añadida directamente sobre el cuadro, sino sobre su representación digital en forma de identificador URI.
Esta información almacenada en un ordenador puede contener una definición de un vocabulario controlado, una «etiqueta» que indica de forma unívoca (un solo significado, sin ambigüedades) de qué tipo de cosa -objeto tangible o intangible- se trata. En breve sigo con esta «etiqueta»*.
La creación, mantenimiento y explotación de esta información permite a la Persona que gestiona el cuadro hacer su trabajo y con ello crear conocimiento universal.
SOLID SEO
Consultoría e Implementación
Más de 20 años de experiencia y conocimiento SEO de todas las épocas y tecnologías se unen a una metodología robusta y sostenible
CONTACTA SIN COMPROMISO
Vocabularios controlados
Se les llama controlados porque son mantenidos de forma coordinada por varias partes, entre instituciones, investigadores, empresas, etc. De esta forma, se publican regularmente los cambios y mejoras que reciben. Un profesional SEO hábil con Schema debe estar al día de dicho vocabulario, por mencionar un caso de amplia penetración en el mercado del marketing online.
¿He mencionado ya que Schema es el vocabulario recomendado por Google?
- Schema: En el contexto de la web, Schema.org es un vocabulario que ayuda a estructurar datos para que los motores de búsqueda puedan entenderlos mejor. Por ejemplo, un restaurante podría usar Schema para listar su menú, horarios de operación y ubicación de una manera que Google pueda mostrar fácilmente en los resultados de búsqueda.
*Ejemplo: retomando la «etiqueta» del cuadro del ejemplo anterior, el vocabulario Schema.org permite «etiquetar» un cuadro artístico como un elemento o entidad del tipo Painting. - IPTC (International Press Telecommunications Council): Es un vocabulario utilizado principalmente en el ámbito de los medios de comunicación y la fotografía. Proporciona un conjunto de metadatos estándar para describir imágenes y otros contenidos multimedia, facilitando su organización y búsqueda. Es usado masivamente en cadenas de televisión, prensa o bancos de imágenes.
- Dublin Core: Es un vocabulario simple y ampliamente utilizado para describir recursos digitales. Incluye un conjunto de 15 elementos básicos, como título, autor, fecha y formato, que ayudan a catalogar y buscar información de manera eficiente. Es comúnmente utilizado en bibliotecas y repositorios digitales; uno de los decanos, que vengo usando desde finales del siglo XX.
- FOAF (Friend of a Friend): Otro anciano. Es un vocabulario utilizado para describir personas y sus relaciones. Permite crear perfiles de usuarios y establecer conexiones entre ellos, lo que fue útil en redes sociales y aplicaciones de gestión de contactos. FOAF es uno de los primeros ejemplos de uso relativamente masivo de RDF para estructurar la información, y se añadió a Schema en 2011, aunque sigue usándose independientemente.
[ Volver al origen ]
Formatos para expresar conceptos usando vocabularios controlados
- RDF (Resource Description Framework): Es un lenguaje para describir información en un formato estructurado. Imagina un catálogo de biblioteca donde cada libro tiene un título, autor y fecha de publicación. RDF puede ser utilizado para describir estas relaciones de una manera que las computadoras puedan entender. Aquí tienes mi artículo de introducción al RDF.
- JSON-LD (JavaScript Object Notation + Linked Data): Es un formato ligero para almacenar y transportar datos, ligado a Datos Enlazados. Piensa en ello como un libro de recetas donde cada receta tiene una lista de ingredientes y pasos. JSON es a menudo utilizado en aplicaciones web para enviar datos entre un servidor y una página web.
Es el formato recomendado por Google para el marcado de Datos Estructurados en un sitio web. - XML (eXtensible Markup Language): Es otro formato para estructurar datos. Es como un conjunto de instrucciones para ensamblar un mueble, donde cada parte está claramente etiquetada y los pasos están numerados. XML es utilizado en muchas industrias, como en finanzas para registros de transacciones o en publicaciones para el formato de documentos.
Su grandeza y amplio uso radican en el hecho de que como su nombre indica, es un formato extensible.
Si trabajas con EDI (logística, finanzas, administración, compras, transportes, gran consumo, etc), estás tocando XML cada día.
Introducción a RDF y la Web Semántica
RDF y la Web Semántica: RDF es fundamental para la Web Semántica, que es una extensión de la web actual donde la información está estructurada y enlazada de manera que las computadoras puedan entenderla y procesarla. La Web Semántica busca hacer que la información en la web sea más significativa y útil, permitiendo que las máquinas comprendan el contexto y las relaciones entre diferentes datos.
Este formato permite utilizar a la vez varias ontologías o vocabularios controlados, de forma que quien quiera usarlo disponga de elementos y atributos específicos a su campo de trabajo.
Por ejemplo, en el caso del cuadro que comentaba antes: en una base de datos o en una página web de un museo tenemos Datos Estructurados expresados en formato JSON-LD y vocabulario Schema.org (metadatos sobre la obra), a la vez una captura digital de la obra podría ser referida en estos Datos Estructurados usando el vocabulario específico de IPTC (metadatos de la imagen digital de la obra), mientras que se podría usar términos de la iniciativa Dublin Core para describir la relación entre varios ficheros digitales que ayudan a identificar, gestionar y preservar el valioso cuadro.
Triples
En el contexto de los datos estructurados, un triple es una forma de describir una pieza de información en tres partes: sujeto, predicado y objeto. Por ejemplo, en la afirmación «El libro 1984 fue escrito por George Orwell,» el sujeto es «El libro 1984,» el predicado es «fue escrito por,» y el objeto es «George Orwell.» Este formato es a menudo utilizado en RDF para describir relaciones entre diferentes piezas de datos, este es pues su unidad mínima de trabajo, un solo triple:
Libro > escrito por > Autor que se lee como
Sujeto > predicado > ObjetoPasamos ahora de un solo triple a un ejemplo con 7 triples. Aquí se puede ver como se teje el conocimiento a partir de premisas sencillas (triples aislados que crean un contexto superior al relacionarse):
Si seguimos elevando la complejidad de las relaciones entre un mayor número de triples, acabamos con visualizaciones densas como este ejemplo real de mi portafolio de clientes:
Nota del autor: resulta interesante matizar el ejemplo básico, como refuerzo de la disparidad entre lenguaje humano y lenguaje estructurado para consumidores de datos:
El predicado «fue escrito por» es natural entre humanos, pero no sería correcto ni preciso en la Web Semántica.
En un entorno interoperable, el predicado es siempre una propiedad formal (URI), para el caso del ejemplo sería schema:author usando el vocabulario Schema.org, si usamos otro como Dublin Core podría ser dcterms:creator.
Entidad Libro [schema:Book] > Propiedad [schema:author] > Entidad Persona [schema:Person]Al utilizar datos estructurados, la sociedad digital puede hacer que su información sea más accesible, indexable y reutilizable; por tanto la información no solamente existe sino que es útil tanto para las personas como para las computadoras. Esta infraestructura de conocimiento es obviamente una herramienta extremadamente valiosa para las industrias, de muchas formas distintas; una de las más evidentes es el Posicionamiento SEO. Organizando y estructurando el contenido se pueden obtener 2 cosas:
- Visibilidad online, mejor interacción con LLMs (IA): si entienden tu empresa, será más visible/citable.
- Conocimiento, ya que cualquier LLM comercial con contexto adecuado puede inferir información nueva a partir de informaciones ya conocidas, pero no relacionadas o vistas «con poco ángulo».
Conceptos relacionados (y otro triple de ejemplo)
[ SOLID SEO ] > [ Consultoría ] > [ SEO ] = [ Empresa ] > [ actividad ] > [ Producto/Servicio ]
Fuentes y relaciones
- Schema SEO: Datos Estructurados [ https://www.seofreelance.es/schema-seo/ ]
- Descriptor Semántico Homogéneo® [ https://www.seofreelance.es/descriptor-semantico-homogeneo-dsh/ ]
Datos Estructurados: Se refiere a la información que está organizada en un formato o patrón específico, lo que facilita su búsqueda, análisis y comprensión.
Piensa en ello como un archivador bien organizado donde cada archivo tiene una etiqueta clara y está colocado en un cajón específico, de una forma específica.
Además disponen de una utilidad añadida: no solamente contienen información útil para algún cometido, también describen las relaciones entre las distintas fuentes de datos.
Un documento con datos estructurados tiene el potencial de no solamente darte la información que contenga, también te indicará su número de orden en una secuencia lógica de documentos, por ejemplo. Eso daría mayor valor y utilidad a los datos consumidos.
Ejemplos de Datos Estructurados:
- Imágenes: las imágenes marcadas como Código de Barras EAN13.
Este tipo de imagen se identifica de tres formas, una por la distribución de las barras en la imagen visible (código numérico, típicamente EAN13 que también es un estándar de Datos Estructurados), el tipo de imagen (puede ser identificado usando un vocabulario controlado como Schema.org); otra por sus metadatos acompañantes. - Documentos de texto digitales:
Datos No Estructurados
Por contra, los Datos No Estructurados se refieren a la información que no sigue un formato o patrón específico y, por lo tanto, es más difícil de organizar, buscar y analizar.
Piensa en ello como una caja llena de papeles sueltos sin ningún orden particular.
Cada papel suelto y desordenado contiene información, pero cuesta mucho relacionarlo con otros papeles y documentación desparramada sin orden aparente.
Ejemplos de Datos No Estructurados:
- Textos Libres: Documentos de texto, correos electrónicos, publicaciones en redes sociales.
- Imágenes y Videos: Fotografías, videos, gráficos.
- Archivos de Audio: Grabaciones de voz, podcasts, música.
- Documentos Escritos a Mano: Notas, cartas, manuscritos, albaranes, facturas.
Diferencias Clave
- Organización:
- Estructurados: Siguen un formato específico y están organizados de manera sistemática.
- No Estructurados: No siguen un formato específico y están organizados de manera más libre y heterogénea.
- Facilidad de Análisis:
- Estructurados: Son más fáciles de analizar y procesar debido a su organización.
- No Estructurados: Son más difíciles de analizar y procesar debido a la falta de estructura y a la posible existencia de muchas excepciones.
- Ejemplos de Uso:
- Estructurados: Bases de datos, hojas de cálculo, formatos como JSON y XML. Usos: Ciencia, EDI, SEO.
- No Estructurados: Documentos de texto, imágenes, videos, archivos de audio. Usos: cultura, ocio, comunicación.
Datos Estructurados en el mundo real
Los datos estructurados son ideales para aplicaciones que requieren un alto grado de organización y facilidad de análisis, como bases de datos y aplicaciones web. No olvidemos que un sitio web es un tipo de aplicación web, de ahí la importancia de incluir Schema SEO en los esfuerzos de posicionamiento web.
Productos cosméticos / Sector Industrial
Hostelería, HORECA, Bodegas y Sectores Primarios
¡Algo tan personal e intransferible como la cata de vinos! Debe ser ordenado y estandarizado para poder formar sommeliers y clasificar las notas de cata de los distintos caldos de cara al consumidor.
Así podemos pasar de «este vino está bien» a «me gusta el vino con notas cítricas y frutos rojos».
Casi sin querer, hemos llegado a un caso clarísimo de acercamiento del producto a su público objetivo. Y es que al dotar al público de esta estructura de datos, este conocimiento, le permitimos expresar su necesidad de forma objetiva: se autosegmenta.
Si pones el cartel «Notas cítricas y frutos rojos» en el lineal de vino tinto, sabrás enseguida quién sabe lo que busca.
Lectura y Cine
Por otro lado, los datos no estructurados son más comunes en contextos donde la información es más libre y variada, en contextos de ocio por ejemplo: documentos de texto literario y medios audiovisuales. Leer e ir al cine o al teatro.
¿Sabías que…? Para ti es una lectura agradable sin más estructura que tus horarios. Pero para el librero o la editorial, hay una gran cantidad de datos estructurados disponibles para catalogar y gestionar cualquier fondo editorial.
Vivimos una realidad híbrida
Ya no estamos solos, ahora somos humanos e IAs. Como sofontes, ambos tipos de datos tienen sus propios usos y desafíos, y a menudo se utilizan en conjunto para obtener una visión más completa de la información.
Pongamos el ejemplo de una obra de arte, un cuadro. Vamos a examinar como podría percibirse siendo un observador casual (una persona que admira la pintura y el arte) o bien un ordenador que reconozca el cuadro (no lo reconocerá literalmente, sino que diferenciará la imagen que capte de este o bien identificará una serie de datos únicos de esta obra de arte).
El cuadro artístico como Datos No Estructurados:
- Una Persona lo verá en su conjunto, puede fijarse en aspectos concretos de zonas concretas del lienzo, puede ver sus colores, puede incluso sentir emociones basadas en esta experiencia.
Pero la gama de colores será falsa, porque será lo que perciben sus ojos: estos colores dependerán de la luz disponible, la salud ocular del observador, el estado de ánimo, etc.
Pero un observador casual puede no saber quién es el artista, ni en qué momento de su vida creó el cuadro, ni qué orden tiene la obra en su colección, ni cuantos colores distintos tiene, etc. - Un ordenador equipado con una cámara puede ser preparado para escanear el cuadro, puede percibir millones de colores, puede comparar la obra con otras y ejecutar decenas de operaciones, pero se centrará en la imagen del objeto. Será solamente un objeto desconocido frente al objetivo de la cámara.
El cuadro artístico como Datos Estructurados:
- Una Persona que se dedique a catalogar y organizar colecciones de arte puede tratar el cuadro concreto como un elemento perfectamente identificado y ubicado entre otros elementos similares, sea por autor, por época, por técnica, etc. Puede gestionar este cuadro para preservarlo y que otras personas puedan disfrutarlo.
- Un ordenador puede alojar una base de datos sobre colecciones de arte, perfectamente catalogadas y organizadas mediante información añadida al cuadro identificado. No añadida directamente sobre el cuadro, sino sobre su representación digital en forma de identificador URI.
Esta información almacenada en un ordenador puede contener una definición de un vocabulario controlado, una «etiqueta» que indica de forma unívoca (un solo significado, sin ambigüedades) de qué tipo de cosa -objeto tangible o intangible- se trata. En breve sigo con esta «etiqueta»*.
La creación, mantenimiento y explotación de esta información permite a la Persona que gestiona el cuadro hacer su trabajo y con ello crear conocimiento universal.
SOLID SEO
Consultoría e Implementación
Más de 20 años de experiencia y conocimiento SEO de todas las épocas y tecnologías se unen a una metodología robusta y sostenible
CONTACTA SIN COMPROMISO
Vocabularios controlados
Se les llama controlados porque son mantenidos de forma coordinada por varias partes, entre instituciones, investigadores, empresas, etc. De esta forma, se publican regularmente los cambios y mejoras que reciben. Un profesional SEO hábil con Schema debe estar al día de dicho vocabulario, por mencionar un caso de amplia penetración en el mercado del marketing online.
¿He mencionado ya que Schema es el vocabulario recomendado por Google?
- Schema: En el contexto de la web, Schema.org es un vocabulario que ayuda a estructurar datos para que los motores de búsqueda puedan entenderlos mejor. Por ejemplo, un restaurante podría usar Schema para listar su menú, horarios de operación y ubicación de una manera que Google pueda mostrar fácilmente en los resultados de búsqueda.
*Ejemplo: retomando la «etiqueta» del cuadro del ejemplo anterior, el vocabulario Schema.org permite «etiquetar» un cuadro artístico como un elemento o entidad del tipo Painting. - IPTC (International Press Telecommunications Council): Es un vocabulario utilizado principalmente en el ámbito de los medios de comunicación y la fotografía. Proporciona un conjunto de metadatos estándar para describir imágenes y otros contenidos multimedia, facilitando su organización y búsqueda. Es usado masivamente en cadenas de televisión, prensa o bancos de imágenes.
- Dublin Core: Es un vocabulario simple y ampliamente utilizado para describir recursos digitales. Incluye un conjunto de 15 elementos básicos, como título, autor, fecha y formato, que ayudan a catalogar y buscar información de manera eficiente. Es comúnmente utilizado en bibliotecas y repositorios digitales; uno de los decanos, que vengo usando desde finales del siglo XX.
- FOAF (Friend of a Friend): Otro anciano. Es un vocabulario utilizado para describir personas y sus relaciones. Permite crear perfiles de usuarios y establecer conexiones entre ellos, lo que fue útil en redes sociales y aplicaciones de gestión de contactos. FOAF es uno de los primeros ejemplos de uso relativamente masivo de RDF para estructurar la información, y se añadió a Schema en 2011, aunque sigue usándose independientemente.
[ Volver al origen ]
Formatos para expresar conceptos usando vocabularios controlados
- RDF (Resource Description Framework): Es un lenguaje para describir información en un formato estructurado. Imagina un catálogo de biblioteca donde cada libro tiene un título, autor y fecha de publicación. RDF puede ser utilizado para describir estas relaciones de una manera que las computadoras puedan entender. Aquí tienes mi artículo de introducción al RDF.
- JSON-LD (JavaScript Object Notation + Linked Data): Es un formato ligero para almacenar y transportar datos, ligado a Datos Enlazados. Piensa en ello como un libro de recetas donde cada receta tiene una lista de ingredientes y pasos. JSON es a menudo utilizado en aplicaciones web para enviar datos entre un servidor y una página web.
Es el formato recomendado por Google para el marcado de Datos Estructurados en un sitio web. - XML (eXtensible Markup Language): Es otro formato para estructurar datos. Es como un conjunto de instrucciones para ensamblar un mueble, donde cada parte está claramente etiquetada y los pasos están numerados. XML es utilizado en muchas industrias, como en finanzas para registros de transacciones o en publicaciones para el formato de documentos.
Su grandeza y amplio uso radican en el hecho de que como su nombre indica, es un formato extensible.
Si trabajas con EDI (logística, finanzas, administración, compras, transportes, gran consumo, etc), estás tocando XML cada día.
Introducción a RDF y la Web Semántica
RDF y la Web Semántica: RDF es fundamental para la Web Semántica, que es una extensión de la web actual donde la información está estructurada y enlazada de manera que las computadoras puedan entenderla y procesarla. La Web Semántica busca hacer que la información en la web sea más significativa y útil, permitiendo que las máquinas comprendan el contexto y las relaciones entre diferentes datos.
Este formato permite utilizar a la vez varias ontologías o vocabularios controlados, de forma que quien quiera usarlo disponga de elementos y atributos específicos a su campo de trabajo.
Por ejemplo, en el caso del cuadro que comentaba antes: en una base de datos o en una página web de un museo tenemos Datos Estructurados expresados en formato JSON-LD y vocabulario Schema.org (metadatos sobre la obra), a la vez una captura digital de la obra podría ser referida en estos Datos Estructurados usando el vocabulario específico de IPTC (metadatos de la imagen digital de la obra), mientras que se podría usar términos de la iniciativa Dublin Core para describir la relación entre varios ficheros digitales que ayudan a identificar, gestionar y preservar el valioso cuadro.
Triples
En el contexto de los datos estructurados, un triple es una forma de describir una pieza de información en tres partes: sujeto, predicado y objeto. Por ejemplo, en la afirmación «El libro 1984 fue escrito por George Orwell,» el sujeto es «El libro 1984,» el predicado es «fue escrito por,» y el objeto es «George Orwell.» Este formato es a menudo utilizado en RDF para describir relaciones entre diferentes piezas de datos, este es pues su unidad mínima de trabajo, un solo triple:
Libro > escrito por > Autor que se lee como
Sujeto > predicado > ObjetoPasamos ahora de un solo triple a un ejemplo con 7 triples. Aquí se puede ver como se teje el conocimiento a partir de premisas sencillas (triples aislados que crean un contexto superior al relacionarse):
Si seguimos elevando la complejidad de las relaciones entre un mayor número de triples, acabamos con visualizaciones densas como este ejemplo real de mi portafolio de clientes:
Nota del autor: resulta interesante matizar el ejemplo básico, como refuerzo de la disparidad entre lenguaje humano y lenguaje estructurado para consumidores de datos:
El predicado «fue escrito por» es natural entre humanos, pero no sería correcto ni preciso en la Web Semántica.
En un entorno interoperable, el predicado es siempre una propiedad formal (URI), para el caso del ejemplo sería schema:author usando el vocabulario Schema.org, si usamos otro como Dublin Core podría ser dcterms:creator.
Entidad Libro [schema:Book] > Propiedad [schema:author] > Entidad Persona [schema:Person]Al utilizar datos estructurados, la sociedad digital puede hacer que su información sea más accesible, indexable y reutilizable; por tanto la información no solamente existe sino que es útil tanto para las personas como para las computadoras. Esta infraestructura de conocimiento es obviamente una herramienta extremadamente valiosa para las industrias, de muchas formas distintas; una de las más evidentes es el Posicionamiento SEO. Organizando y estructurando el contenido se pueden obtener 2 cosas:
- Visibilidad online, mejor interacción con LLMs (IA): si entienden tu empresa, será más visible/citable.
- Conocimiento, ya que cualquier LLM comercial con contexto adecuado puede inferir información nueva a partir de informaciones ya conocidas, pero no relacionadas o vistas «con poco ángulo».
Conceptos relacionados (y otro triple de ejemplo)
[ SOLID SEO ] > [ Consultoría ] > [ SEO ] = [ Empresa ] > [ actividad ] > [ Producto/Servicio ]
Fuentes y relaciones
- Schema SEO: Datos Estructurados [ https://www.seofreelance.es/schema-seo/ ]
- Descriptor Semántico Homogéneo® [ https://www.seofreelance.es/descriptor-semantico-homogeneo-dsh/ ]
Datos Estructurados
Datos Estructurados: Se refiere a la información que está organizada en un formato o patrón específico, lo que facilita su búsqueda, análisis y comprensión.
Piensa en ello como un archivador bien organizado donde cada archivo tiene una etiqueta clara y está colocado en un cajón específico, de una forma específica.
Además disponen de una utilidad añadida: no solamente contienen información útil para algún cometido, también describen las relaciones entre las distintas fuentes de datos.
Un documento con datos estructurados tiene el potencial de no solamente darte la información que contenga, también te indicará su número de orden en una secuencia lógica de documentos, por ejemplo. Eso daría mayor valor y utilidad a los datos consumidos.
Ejemplos de Datos Estructurados:
- Imágenes: las imágenes marcadas como Código de Barras EAN13.
Este tipo de imagen se identifica de tres formas, una por la distribución de las barras en la imagen visible (código numérico, típicamente EAN13 que también es un estándar de Datos Estructurados), el tipo de imagen (puede ser identificado usando un vocabulario controlado como Schema.org); otra por sus metadatos acompañantes. - Documentos de texto digitales:
Datos No Estructurados
Por contra, los Datos No Estructurados se refieren a la información que no sigue un formato o patrón específico y, por lo tanto, es más difícil de organizar, buscar y analizar.
Piensa en ello como una caja llena de papeles sueltos sin ningún orden particular.
Cada papel suelto y desordenado contiene información, pero cuesta mucho relacionarlo con otros papeles y documentación desparramada sin orden aparente.
Ejemplos de Datos No Estructurados:
- Textos Libres: Documentos de texto, correos electrónicos, publicaciones en redes sociales.
- Imágenes y Videos: Fotografías, videos, gráficos.
- Archivos de Audio: Grabaciones de voz, podcasts, música.
- Documentos Escritos a Mano: Notas, cartas, manuscritos, albaranes, facturas.
Diferencias Clave
- Organización:
- Estructurados: Siguen un formato específico y están organizados de manera sistemática.
- No Estructurados: No siguen un formato específico y están organizados de manera más libre y heterogénea.
- Facilidad de Análisis:
- Estructurados: Son más fáciles de analizar y procesar debido a su organización.
- No Estructurados: Son más difíciles de analizar y procesar debido a la falta de estructura y a la posible existencia de muchas excepciones.
- Ejemplos de Uso:
- Estructurados: Bases de datos, hojas de cálculo, formatos como JSON y XML. Usos: Ciencia, EDI, SEO.
- No Estructurados: Documentos de texto, imágenes, videos, archivos de audio. Usos: cultura, ocio, comunicación.
Datos Estructurados en el mundo real
Los datos estructurados son ideales para aplicaciones que requieren un alto grado de organización y facilidad de análisis, como bases de datos y aplicaciones web. No olvidemos que un sitio web es un tipo de aplicación web, de ahí la importancia de incluir Schema SEO en los esfuerzos de posicionamiento web.
Productos cosméticos / Sector Industrial
Hostelería, HORECA, Bodegas y Sectores Primarios
¡Algo tan personal e intransferible como la cata de vinos! Debe ser ordenado y estandarizado para poder formar sommeliers y clasificar las notas de cata de los distintos caldos de cara al consumidor.
Así podemos pasar de «este vino está bien» a «me gusta el vino con notas cítricas y frutos rojos».
Casi sin querer, hemos llegado a un caso clarísimo de acercamiento del producto a su público objetivo. Y es que al dotar al público de esta estructura de datos, este conocimiento, le permitimos expresar su necesidad de forma objetiva: se autosegmenta.
Si pones el cartel «Notas cítricas y frutos rojos» en el lineal de vino tinto, sabrás enseguida quién sabe lo que busca.
Lectura y Cine
Por otro lado, los datos no estructurados son más comunes en contextos donde la información es más libre y variada, en contextos de ocio por ejemplo: documentos de texto literario y medios audiovisuales. Leer e ir al cine o al teatro.
¿Sabías que…? Para ti es una lectura agradable sin más estructura que tus horarios. Pero para el librero o la editorial, hay una gran cantidad de datos estructurados disponibles para catalogar y gestionar cualquier fondo editorial.
Vivimos una realidad híbrida
Ya no estamos solos, ahora somos humanos e IAs. Como sofontes, ambos tipos de datos tienen sus propios usos y desafíos, y a menudo se utilizan en conjunto para obtener una visión más completa de la información.
Pongamos el ejemplo de una obra de arte, un cuadro. Vamos a examinar como podría percibirse siendo un observador casual (una persona que admira la pintura y el arte) o bien un ordenador que reconozca el cuadro (no lo reconocerá literalmente, sino que diferenciará la imagen que capte de este o bien identificará una serie de datos únicos de esta obra de arte).
El cuadro artístico como Datos No Estructurados:
- Una Persona lo verá en su conjunto, puede fijarse en aspectos concretos de zonas concretas del lienzo, puede ver sus colores, puede incluso sentir emociones basadas en esta experiencia.
Pero la gama de colores será falsa, porque será lo que perciben sus ojos: estos colores dependerán de la luz disponible, la salud ocular del observador, el estado de ánimo, etc.
Pero un observador casual puede no saber quién es el artista, ni en qué momento de su vida creó el cuadro, ni qué orden tiene la obra en su colección, ni cuantos colores distintos tiene, etc. - Un ordenador equipado con una cámara puede ser preparado para escanear el cuadro, puede percibir millones de colores, puede comparar la obra con otras y ejecutar decenas de operaciones, pero se centrará en la imagen del objeto. Será solamente un objeto desconocido frente al objetivo de la cámara.
El cuadro artístico como Datos Estructurados:
- Una Persona que se dedique a catalogar y organizar colecciones de arte puede tratar el cuadro concreto como un elemento perfectamente identificado y ubicado entre otros elementos similares, sea por autor, por época, por técnica, etc. Puede gestionar este cuadro para preservarlo y que otras personas puedan disfrutarlo.
- Un ordenador puede alojar una base de datos sobre colecciones de arte, perfectamente catalogadas y organizadas mediante información añadida al cuadro identificado. No añadida directamente sobre el cuadro, sino sobre su representación digital en forma de identificador URI.
Esta información almacenada en un ordenador puede contener una definición de un vocabulario controlado, una «etiqueta» que indica de forma unívoca (un solo significado, sin ambigüedades) de qué tipo de cosa -objeto tangible o intangible- se trata. En breve sigo con esta «etiqueta»*.
La creación, mantenimiento y explotación de esta información permite a la Persona que gestiona el cuadro hacer su trabajo y con ello crear conocimiento universal.
SOLID SEO
Consultoría e Implementación
Más de 20 años de experiencia y conocimiento SEO de todas las épocas y tecnologías se unen a una metodología robusta y sostenible
CONTACTA SIN COMPROMISO
Vocabularios controlados
Se les llama controlados porque son mantenidos de forma coordinada por varias partes, entre instituciones, investigadores, empresas, etc. De esta forma, se publican regularmente los cambios y mejoras que reciben. Un profesional SEO hábil con Schema debe estar al día de dicho vocabulario, por mencionar un caso de amplia penetración en el mercado del marketing online.
¿He mencionado ya que Schema es el vocabulario recomendado por Google?
- Schema: En el contexto de la web, Schema.org es un vocabulario que ayuda a estructurar datos para que los motores de búsqueda puedan entenderlos mejor. Por ejemplo, un restaurante podría usar Schema para listar su menú, horarios de operación y ubicación de una manera que Google pueda mostrar fácilmente en los resultados de búsqueda.
*Ejemplo: retomando la «etiqueta» del cuadro del ejemplo anterior, el vocabulario Schema.org permite «etiquetar» un cuadro artístico como un elemento o entidad del tipo Painting. - IPTC (International Press Telecommunications Council): Es un vocabulario utilizado principalmente en el ámbito de los medios de comunicación y la fotografía. Proporciona un conjunto de metadatos estándar para describir imágenes y otros contenidos multimedia, facilitando su organización y búsqueda. Es usado masivamente en cadenas de televisión, prensa o bancos de imágenes.
- Dublin Core: Es un vocabulario simple y ampliamente utilizado para describir recursos digitales. Incluye un conjunto de 15 elementos básicos, como título, autor, fecha y formato, que ayudan a catalogar y buscar información de manera eficiente. Es comúnmente utilizado en bibliotecas y repositorios digitales; uno de los decanos, que vengo usando desde finales del siglo XX.
- FOAF (Friend of a Friend): Otro anciano. Es un vocabulario utilizado para describir personas y sus relaciones. Permite crear perfiles de usuarios y establecer conexiones entre ellos, lo que fue útil en redes sociales y aplicaciones de gestión de contactos. FOAF es uno de los primeros ejemplos de uso relativamente masivo de RDF para estructurar la información, y se añadió a Schema en 2011, aunque sigue usándose independientemente.
[ Volver al origen ]
Formatos para expresar conceptos usando vocabularios controlados
- RDF (Resource Description Framework): Es un lenguaje para describir información en un formato estructurado. Imagina un catálogo de biblioteca donde cada libro tiene un título, autor y fecha de publicación. RDF puede ser utilizado para describir estas relaciones de una manera que las computadoras puedan entender. Aquí tienes mi artículo de introducción al RDF.
- JSON-LD (JavaScript Object Notation + Linked Data): Es un formato ligero para almacenar y transportar datos, ligado a Datos Enlazados. Piensa en ello como un libro de recetas donde cada receta tiene una lista de ingredientes y pasos. JSON es a menudo utilizado en aplicaciones web para enviar datos entre un servidor y una página web.
Es el formato recomendado por Google para el marcado de Datos Estructurados en un sitio web. - XML (eXtensible Markup Language): Es otro formato para estructurar datos. Es como un conjunto de instrucciones para ensamblar un mueble, donde cada parte está claramente etiquetada y los pasos están numerados. XML es utilizado en muchas industrias, como en finanzas para registros de transacciones o en publicaciones para el formato de documentos.
Su grandeza y amplio uso radican en el hecho de que como su nombre indica, es un formato extensible.
Si trabajas con EDI (logística, finanzas, administración, compras, transportes, gran consumo, etc), estás tocando XML cada día.
Introducción a RDF y la Web Semántica
RDF y la Web Semántica: RDF es fundamental para la Web Semántica, que es una extensión de la web actual donde la información está estructurada y enlazada de manera que las computadoras puedan entenderla y procesarla. La Web Semántica busca hacer que la información en la web sea más significativa y útil, permitiendo que las máquinas comprendan el contexto y las relaciones entre diferentes datos.
Este formato permite utilizar a la vez varias ontologías o vocabularios controlados, de forma que quien quiera usarlo disponga de elementos y atributos específicos a su campo de trabajo.
Por ejemplo, en el caso del cuadro que comentaba antes: en una base de datos o en una página web de un museo tenemos Datos Estructurados expresados en formato JSON-LD y vocabulario Schema.org (metadatos sobre la obra), a la vez una captura digital de la obra podría ser referida en estos Datos Estructurados usando el vocabulario específico de IPTC (metadatos de la imagen digital de la obra), mientras que se podría usar términos de la iniciativa Dublin Core para describir la relación entre varios ficheros digitales que ayudan a identificar, gestionar y preservar el valioso cuadro.
Triples
En el contexto de los datos estructurados, un triple es una forma de describir una pieza de información en tres partes: sujeto, predicado y objeto. Por ejemplo, en la afirmación «El libro 1984 fue escrito por George Orwell,» el sujeto es «El libro 1984,» el predicado es «fue escrito por,» y el objeto es «George Orwell.» Este formato es a menudo utilizado en RDF para describir relaciones entre diferentes piezas de datos, este es pues su unidad mínima de trabajo, un solo triple:
Libro > escrito por > Autor que se lee como
Sujeto > predicado > ObjetoPasamos ahora de un solo triple a un ejemplo con 7 triples. Aquí se puede ver como se teje el conocimiento a partir de premisas sencillas (triples aislados que crean un contexto superior al relacionarse):
Si seguimos elevando la complejidad de las relaciones entre un mayor número de triples, acabamos con visualizaciones densas como este ejemplo real de mi portafolio de clientes:
Nota del autor: resulta interesante matizar el ejemplo básico, como refuerzo de la disparidad entre lenguaje humano y lenguaje estructurado para consumidores de datos:
El predicado «fue escrito por» es natural entre humanos, pero no sería correcto ni preciso en la Web Semántica.
En un entorno interoperable, el predicado es siempre una propiedad formal (URI), para el caso del ejemplo sería schema:author usando el vocabulario Schema.org, si usamos otro como Dublin Core podría ser dcterms:creator.
Entidad Libro [schema:Book] > Propiedad [schema:author] > Entidad Persona [schema:Person]Al utilizar datos estructurados, la sociedad digital puede hacer que su información sea más accesible, indexable y reutilizable; por tanto la información no solamente existe sino que es útil tanto para las personas como para las computadoras. Esta infraestructura de conocimiento es obviamente una herramienta extremadamente valiosa para las industrias, de muchas formas distintas; una de las más evidentes es el Posicionamiento SEO. Organizando y estructurando el contenido se pueden obtener 2 cosas:
- Visibilidad online, mejor interacción con LLMs (IA): si entienden tu empresa, será más visible/citable.
- Conocimiento, ya que cualquier LLM comercial con contexto adecuado puede inferir información nueva a partir de informaciones ya conocidas, pero no relacionadas o vistas «con poco ángulo».
Conceptos relacionados (y otro triple de ejemplo)
[ SOLID SEO ] > [ Consultoría ] > [ SEO ] = [ Empresa ] > [ actividad ] > [ Producto/Servicio ]
Fuentes y relaciones
- Schema SEO: Datos Estructurados [ https://www.seofreelance.es/schema-seo/ ]
- Descriptor Semántico Homogéneo® [ https://www.seofreelance.es/descriptor-semantico-homogeneo-dsh/ ]
Últimas Entradas del Blog
- 04/08/26
Protocolo institucional y grafo de conocimiento
- 06/07/26
Inversión SEO a largo plazo: lo que el ROAS no puede medir

- 09/06/26
Certificado de Origen


- 29/05/26
Expoquimia y el sector químico en Catalunya


- 22/04/26
Antes de comenzar a construir una web


- 20/03/26
La Liga y el bloqueo indiscriminado de webs legítimas


- 29/09/25
Ontología vs Vocabulario ¿Son lo mismo?


- 15/07/25
SEO para IA o Estrategias de SEO Semántico para optimización ante la Búsqueda Generativa


- 12/05/25
SEO para pequeños comercios


